Sumário
1. Modelos Não Supervisionados
Definição: Modelos não supervisionados são aqueles que trabalham com dados não rotulados, ou seja, dados que não possuem uma variável de saída definida.
Uso:
- Clusterização: Agrupar dados em clusters (ou grupos) que têm características semelhantes. Exemplo: K-means, DBSCAN.
- Redução de Dimensionalidade: Reduzir o número de variáveis (ou características) em um conjunto de dados. Exemplo: PCA (Análise de Componentes Principais), t-SNE.
- Associação: Encontrar regras de associação entre grandes conjuntos de dados. Exemplo: Apriori, FP-Growth.
Aplicação: Análise exploratória de dados, segmentação de clientes, compressão de dados.
2. Aprendizado por Reforço
Definição: O aprendizado por reforço é uma área do aprendizado de máquina onde um agente aprende a tomar decisões através de tentativas e erros, recebendo recompensas ou penalidades com base nas ações tomadas.
Uso:
- Jogos: Desenvolvimento de agentes que podem jogar jogos complexos e vencer jogadores humanos. Exemplo: AlphaGo.
- Robótica: Treinamento de robôs para realizar tarefas físicas, como caminhar ou manipular objetos.
- Sistemas de Recomendação: Otimização de recomendações com base no feedback contínuo do usuário.
Aplicação: Controle de sistemas autônomos, otimização de processos industriais, finanças (estratégias de trading).
3. Modelos de Classificação
Definição: Modelos de classificação são tipos de aprendizado supervisionado usados para prever a categoria (ou classe) a que uma nova observação pertence, com base em um conjunto de dados de treinamento que contém observações cujas categorias são conhecidas.
Uso:
- Classificação Binária: Decidir entre duas classes. Exemplo: Detecção de spam (spam ou não spam).
- Classificação Multiclasse: Classificar entre mais de duas classes. Exemplo: Reconhecimento de dígitos escritos à mão.
- Classificação Multirrótulo: Atribuir múltiplas etiquetas a cada observação. Exemplo: Etiquetar imagens com múltiplos objetos.
Aplicação: Diagnóstico médico, análise de crédito, reconhecimento de padrões, detecção de fraudes.
4. Modelos de Forecasting
Definição: Modelos de forecasting são usados para prever valores futuros com base em dados históricos. Estes modelos são especialmente úteis para dados temporais, onde o tempo é uma variável significativa.
Uso:
- Séries Temporais: Previsão de vendas, demanda, preços de ações. Exemplo: ARIMA, Prophet, LSTM.
- Análise de Tendências: Identificação de tendências e padrões sazonais.
- Previsão de Eventos: Antecipação de eventos futuros com base em dados históricos.
Aplicação: Planejamento financeiro, gerenciamento de inventário, previsão de carga elétrica, análise de mercado.
Cada um desses tipos de modelos tem suas aplicações específicas e é escolhido com base na natureza dos dados e no problema a ser resolvido.
Explicação do Modelo 60/20/20
- 60% Treinamento:
- Descrição: Nesta etapa, 60% dos dados disponíveis são usados para treinar o modelo. O objetivo é ajustar os parâmetros internos do modelo para minimizar o erro de previsão sobre os dados de treinamento.
- Processo: O modelo aprende a partir dos dados fornecidos, ajustando seus pesos e vieses de acordo com um algoritmo de aprendizado específico, como regressão linear, redes neurais, entre outros.
- Resultado: Um modelo que se ajusta bem aos dados de treinamento, tentando capturar as relações subjacentes nos dados.
- 20% Validação:
- Descrição: Após o treinamento, 20% dos dados são usados para validar o modelo. Estes dados não foram vistos pelo modelo durante o treinamento e servem para ajustar hiperparâmetros e evitar o overfitting.
- Processo: O modelo é testado com os dados de validação e seu desempenho é avaliado. Hiperparâmetros, como a taxa de aprendizado ou o número de camadas em uma rede neural, podem ser ajustados com base no desempenho do modelo.
- Resultado: Um modelo ajustado que não só se adapta bem aos dados de treinamento, mas também generaliza bem para novos dados. A validação ajuda a identificar se o modelo está aprendendo padrões reais ou apenas memorizando os dados de treinamento.
- 20% Teste:
- Descrição: Finalmente, 20% dos dados são usados para testar o modelo. Estes dados são completamente novos para o modelo e são usados para avaliar sua performance final e generalização.
- Processo: O modelo é aplicado aos dados de teste para prever resultados, e a performance é medida utilizando métricas como acurácia, precisão, recall, F1-score, etc.
- Resultado: Uma avaliação objetiva e final do desempenho do modelo. Esta etapa fornece uma estimativa de quão bem o modelo pode ser esperado para performar em dados reais, nunca vistos antes.
Etapas de Treino, Validação e Teste
- Treinamento:
- Objetivo: Ajustar os parâmetros do modelo para minimizar a função de perda nos dados de treinamento.
- Algoritmos: Gradiente descendente, propagação para trás (backpropagation) em redes neurais, etc.
- Ajustes: Pesos dos modelos, coeficientes, parâmetros internos.
- Validação:
- Objetivo: Ajustar hiperparâmetros e prevenir overfitting.
- Métodos: Cross-validation (validação cruzada), onde o conjunto de dados de validação pode ser dividido em vários subconjuntos para validar o modelo em diferentes partes dos dados.
- Ajustes: Hiperparâmetros como a taxa de aprendizado, número de camadas em redes neurais, número de árvores em uma floresta aleatória, etc.
- Teste:
- Objetivo: Avaliar a performance final do modelo.
- Métodos: Aplicação direta do modelo aos dados de teste para prever resultados e comparação com os valores reais.
- Métricas: Acurácia, precisão, recall, F1-score, RMSE (erro quadrático médio), MAE (erro absoluto médio), MAPE (erro percentual absoluto médio), entre outros.
Resumo
A divisão 60/20/20 é uma estratégia eficaz para desenvolver modelos de aprendizado de máquina robustos. Treinamento é usado para ajustar os parâmetros do modelo, validação para ajustar hiperparâmetros e evitar overfitting, e teste para avaliar a generalização do modelo. Essa abordagem ajuda a garantir que o modelo não apenas aprenda bem a partir dos dados disponíveis, mas também seja capaz de performar bem em dados futuros e desconhecidos.
Erro Percentual Médio Absoluto (MAPE)
Definição: O MAPE (Mean Absolute Percentage Error) é uma métrica usada para medir a precisão de um modelo de previsão. Ele expressa a precisão como uma porcentagem, o que facilita a interpretação e a comparação entre diferentes modelos.
Fórmula:
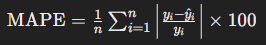
Onde:

é o valor real.

é o valor previsto.

é o número de observações.
Interpretação:
- Um MAPE de 5% significa que, em média, a previsão está errando por 5% do valor real.
- Um MAPE menor indica um modelo mais preciso, enquanto um MAPE maior indica um modelo menos preciso.
Vantagens:
- Facilidade de interpretação como porcentagem.
- Comparabilidade entre diferentes conjuntos de dados.
Desvantagens:
- Pode ser distorcido por valores muito pequenos de yi, levando a erros percentuais muito altos.

- Não é simétrico e penaliza previsões negativas de forma diferente das previsões positivas.
Outras Métricas de Verificação de Precisão de Previsão
-
Erro Médio Absoluto (MAE)
- Definição: Mede a média das diferenças absolutas entre os valores reais e previstos.
- Fórmula:
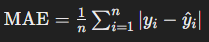
- Interpretação: Um MAE menor indica uma previsão mais precisa.
-
Erro Quadrático Médio (MSE)
- Definição: Mede a média dos quadrados das diferenças entre os valores reais e previstos.
- Fórmula:
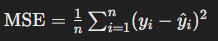
- Interpretação: Um MSE menor indica uma previsão mais precisa. Penaliza erros grandes de forma mais severa do que o MAE.
-
Raiz do Erro Quadrático Médio (RMSE)
- Definição: A raiz quadrada do MSE, trazendo a métrica de volta à mesma unidade dos valores reais.
- Fórmula:
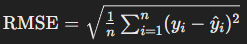
- Interpretação: Um RMSE menor indica uma previsão mais precisa. Facilmente interpretável e penaliza erros grandes de forma severa.
-
Erro Percentual Absoluto Médio Ajustado (sMAPE)
- Definição: Uma versão ajustada do MAPE que lida melhor com valores pequenos.
- Fórmula:
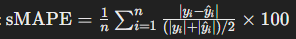
- Interpretação: Um sMAPE menor indica uma previsão mais precisa, e é simétrico.
-
Coeficiente de Determinação (R²)
- Definição: Mede a proporção da variabilidade nos dados de resposta que é explicada pelo modelo.
- Fórmula:
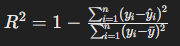
- Interpretação: Um valor de R² mais próximo de 1 indica uma previsão mais precisa. Pode ser negativo se o modelo for pior que a média.

Escolha da Métrica
A escolha da métrica de verificação de precisão depende do contexto e dos objetivos específicos da previsão:
- MAPE: Útil para interpretar erros relativos em porcentagens.
- MAE: Facilmente interpretável e útil para compreender o erro médio absoluto.
- MSE e RMSE: Penalizam erros maiores de forma mais severa e são úteis quando grandes erros são especialmente indesejados.
- sMAPE: Melhor para lidar com valores pequenos e fornece uma métrica simétrica.
- R²: Útil para entender a explicação da variabilidade dos dados pelo modelo.
Cada métrica tem suas vantagens e desvantagens, e a escolha correta depende da natureza do problema e dos dados.